理解结果
你已运行第一次扫描并生成每日报告文件。本页讲解 Sweepy 为你找到的数据。
打开示例报告,它来自 Alex 的律师助理扫描。报告中展示一条简历轨道的六个匹配结果。你可对照参考。
阅读 PDF 报告
打开 results 文件夹中的 PDF 文件。Sweepy 生成每页 6 张卡片的高密度目录。引擎按匹配度从高到低排列职位。
每张卡片代表一个有效职位空缺。下例是 Alex 律师助理扫描中的一张卡片:
┌────────────────────────────────────────────────────────────────────────┐
│  Rank: #1                                                              │
│  Match: 92% KEYWORD OVERLAP                                            │
│  [SUBMIT: Alex_Rivera_Resume]                                          │
│  [STANDARD / QUICK APPLY]                                              │
│                                                                        │
│  Role: Litigation Paralegal                                            │
│  Company: Hoagland Longo Moran Dunst Doukas                            │
│  Location: New Brunswick, NJ, US                                       │
│                                                                        │
│  Overview: About the Role: Hoagland, Longo, Moran, DunstDoukas, LLP is │
│  seeking an experienced and detail-oriented Litigation Paralegal to    │
│  support attorneys.                                                    │
│  Key Requirements: Associate's degree, bachelor's degree, or Paralegal │
│  Certificate from an ABA-approved program preferred.                   │
│  Application Tip: Highlight your e-discovery, Legal Research,          │
│  document management experience in your application.                   │
│                                                                        │
│  Comp & Benefits: $45K - $65K  |  Not disclosed                        │
│  Application Format: Standard Application                              │
│  Apply: [Apply on Indeed Job Board]                                    │
└────────────────────────────────────────────────────────────────────────┘
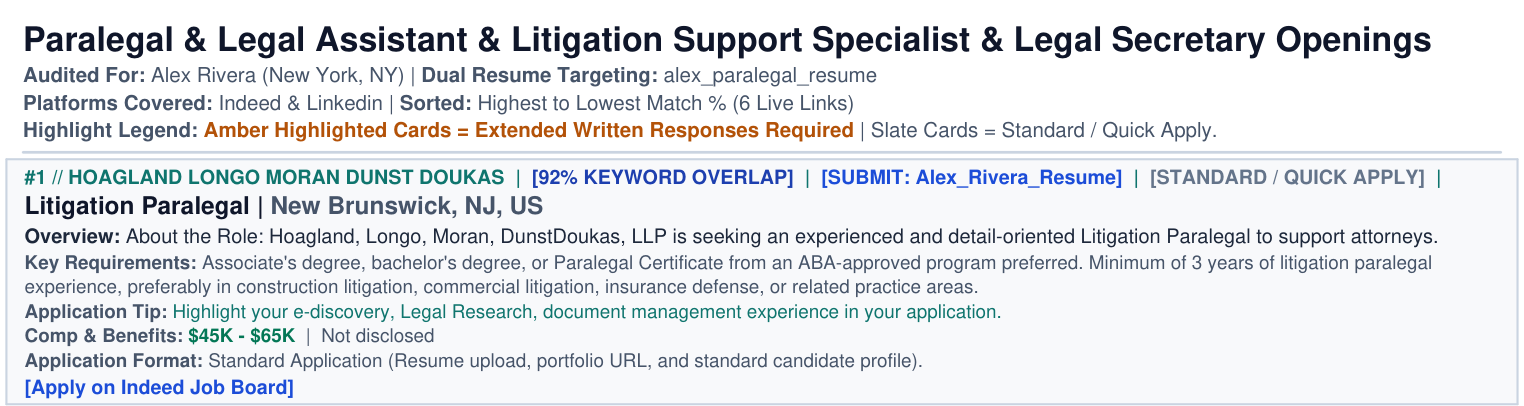
匹配度得分
引擎解析职位描述,并与从你的 PDF 或 Word 简历中提取的文本比对。任职要求重合度占分数的 60%,关键词重合度占其余 40%:
- 任职要求重合度衡量职位原文中你的简历已体现的表述。
- 关键词重合度衡量职位中重复出现的简历词汇。
75% 的分数表示职位与简历在这两项指标上覆盖了大部分相同的加权词条。标为必需的职位词条权重是未标注词条的两倍,优选词条的权重为一半。
卡片在分数旁打印 75% KEYWORD OVERLAP。该标签表示综合得分,并非那 40% 的占比。通过模型上下文协议(MCP)连接的模型可以自行设定百分比,这类卡片改显示 75% MATCH。评分指南 介绍完整公式。
把分数当作排序信号。数值高只说明词汇重合多。查看卡片上的 Application Tip 一行,再自行判断资历、职责范围和职业方向。只在同一份报告内比较分数,因为 keywords_weight 会改变不同配置文件的分数尺度。
提交徽标
[SUBMIT: <resume track>] 徽标标明 Sweepy 为该职位分配的简历轨道。当配置文件定义了 resume.tracks 时,引擎把每个职位发送到与其词条重合最多的轨道。徽标以该轨道的颜色打印。单简历配置文件使用简历文件名作为轨道名称。
薪资与福利
Sweepy 找到薪资数据时会打印格式化区间。Greenhouse 元数据、Lever 薪资区间和 Ashby 薪酬等级提供结构化字段。纽约招聘网站 Built In NYC 在每个职位中列出薪资,Sweepy 会读取。Workable 不发送薪资数据,因此 Sweepy 从职位文本中提取第一个可信数值。
卡片沿用职位使用的单位。小时制职位显示 $45 - $55 / hour,月薪职位显示 $8K - $10K / month,年薪职位显示 $85K - $110K。Sweepy 跳过与奖金、股权、融资轮次和补贴相关的数字。在配置文件中设置 search.salary_from_description: false,可仅读取结构化字段。
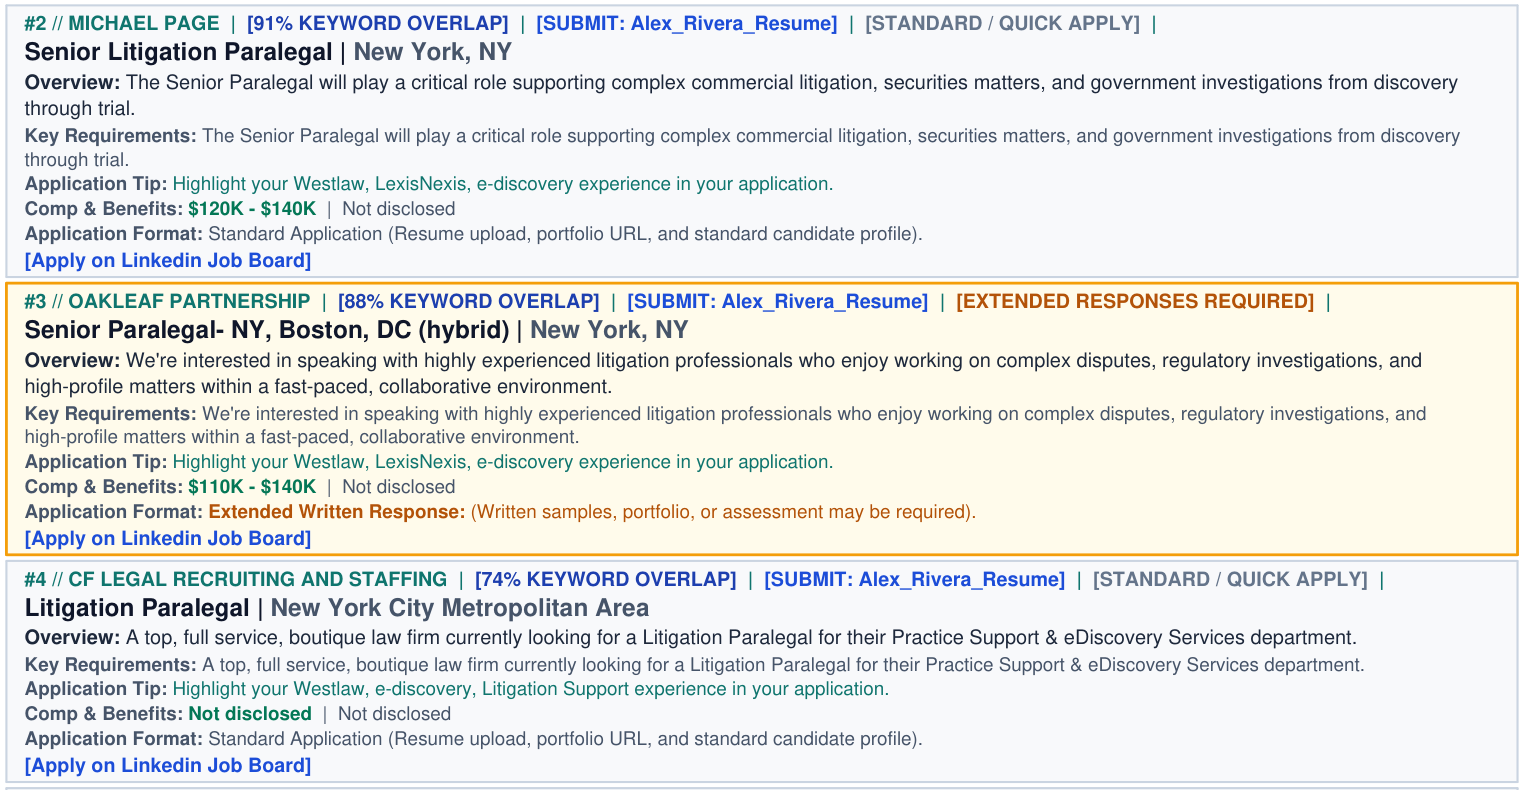
search.min_salary 过滤器按年薪比较。Sweepy 将小时薪资按 2,080 小时换算,将月薪按 12 个月换算。随后剔除年薪上限低于 search.min_salary 的职位。
未接入模型时,福利一律显示 Not disclosed。通过 MCP 连接的模型可用 submit_judgments 写入这两行,并可提供招聘网站从未发布的薪资数据。
申请建议与策略指南
卡片上的建议与结尾的策略表用途不同。每张卡片打印各自的建议,报告结尾只附一张策略表。
Application Tip 出现在每张卡片上。评分器挑选职位与简历共有的前三个词条,并用一句话列出。若没有重合词条,建议回退为通用说明。
Highlight your Litigation Support, document management, court filings experience in your application.
Tailor your cover letter to the core responsibilities listed in the role.
模型可通过 submit_judgments 的 alignment 字段替换该行。
Playbook 在每份报告中出现一次,位于最后一页最后一张卡片之后。标题显示 APPLICATION STRATEGY // DUAL RESUME ROUTING & WORKFLOW PLAYBOOK。该表按 Amber 和 Slate 两类职位分组,并说明每条简历轨道覆盖多少个职位。
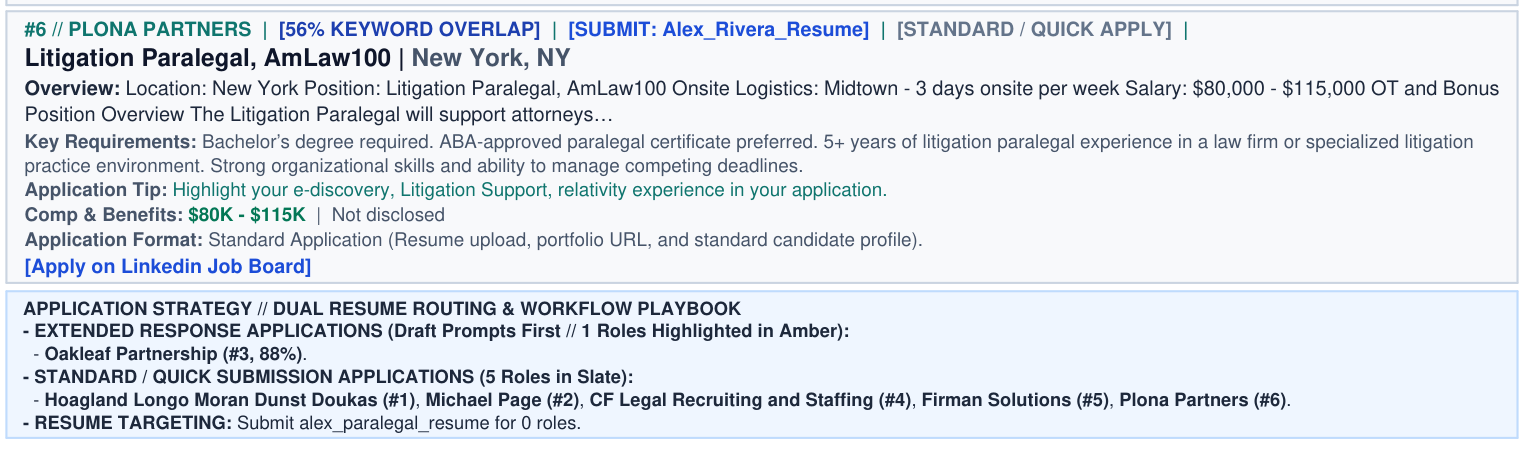
通过 MCP,助手可以用自己的策略说明替换该表。把纯文本传给 render_report,打印结果与你输入的内容基本一致。& 符号和尖括号原样保留,换行转为行分隔,**bold** 添加强调。Sweepy 将该说明随会话保存,后续渲染继续沿用。
可点击链接
每张卡片链接到职位本身。原生读取器提供雇主的招聘页面,聚合器提供来源招聘网站。点击 [Apply on <platform> Job Board] 会在浏览器中打开该页面。Sweepy 从 Greenhouse、Lever、Ashby、Workable 和 Built In NYC 原生读取职位。可选的 openroles 和 jobdrop 引擎增加 Workday。
申请徽标与简历轨道
Sweepy 扫描每个职位中的长文本应答信号,并为每张卡片添加徽标。该徽标在你打开链接之前就显示申请需要投入的精力。
- Slate 卡片表示标准申请或快速申请。申请只需上传简历并填写基本联系方式。多数几分钟即可完成。
- Amber 卡片表示需要长文本应答。申请要求真正的写作。可能需提交作品样本、求职信或针对公司的定制问答题。
用徽标安排节奏。在 15 分钟的短暂休息里投递五到十份 Slate 申请。把 Amber 申请留到能专注一小时撰写定制应答的时候。
使用 CSV 导出文件
除 PDF 外,引擎还会写出配套的 CSV 文件。CSV 是逗号分隔值格式,文件中保存原始表格数据。
PDF 适合阅读和打开链接。CSV 便于跟踪流水线。每行包含卡片字段以及一段职位摘录。Sweepy 将摘录截取到 1,000 字符,并在句子边界处断开。该摘录符合 Notion 单元格 2,000 字符的上限,在 Excel 中也能正常阅读。badge、match_score、min_amount、max_amount、currency、key_matches、missing_skills 和 playbook 列重复了 PDF 中以徽标、百分比、薪资区间和申请建议呈现的值。CSV 还包含超出 PDF 上限的职位,该上限默认为 24 张卡片。
在 Microsoft Excel 或 Google Sheets 中跟踪
CSV 末尾有八个跟踪列:date_applied、status、interview_stage、offer_amount、offer_date、follow_up_date、contact 和 notes。随着流程推进填写这些列。双击 .csv 文件即可在 Excel 中打开,或上传到 Google Sheets。
Sweepy 读取同一配置文件此前的导出文件,并将你填写的内容复制到最新文件。周一标记为 Applied 的职位,周五仍显示 Applied。匹配依据职位链接,链接被替换时仍可通过职位名称、公司和地点匹配。可在配置文件中设置 export.tracking: false 关闭这些列,也可在扫描设置中关闭。
导入 Notion
Notion 把 CSV 行追加到整页数据库。它从不更新已有行,因此请导入一个文件,之后的变化在 Notion 中跟踪。
将 CSV 导入 Notion 数据库的步骤:
- 打开你的 Notion 工作区。
- 新建页面,在 Get started with 下选择 Table 或 Board。
- 打开整页数据库上的
...菜单,选择 Merge with CSV,然后选择你生成的文件。 - 将每个 CSV 列映射到 Notion 属性。Notion 会为每个表头创建属性,与已有属性同名的表头则直接填入该属性。
Notion 无法根据 CSV 建立关联、汇总或公式。
你的每日扫描
你已安装 Sweepy 并配置了搜索配置文件。你也读完了第一批匹配报告。
现在你已具备自动执行职位搜索的全部条件。每天早晨运行扫描,然后投递最匹配的职位。
祝你好运。