結果の読み方
初回スイープを実行し、日次レポートのファイルを生成しました。このページでは、Sweepy が見つけたデータを順に説明します。
Alex のパラリーガル向けスイープからサンプルレポートを開いてください。1 つの履歴書トラックに対する 6 件のマッチが載っています。手元で照らし合わせるリファレンスとして使ってください。
PDF レポートを読む
results フォルダーの PDF ファイルを開きます。Sweepy は 1 ページ 6 枚のカードを持つ高密度のディレクトリを生成します。エンジンはマッチ率の高い順に求人を並べます。
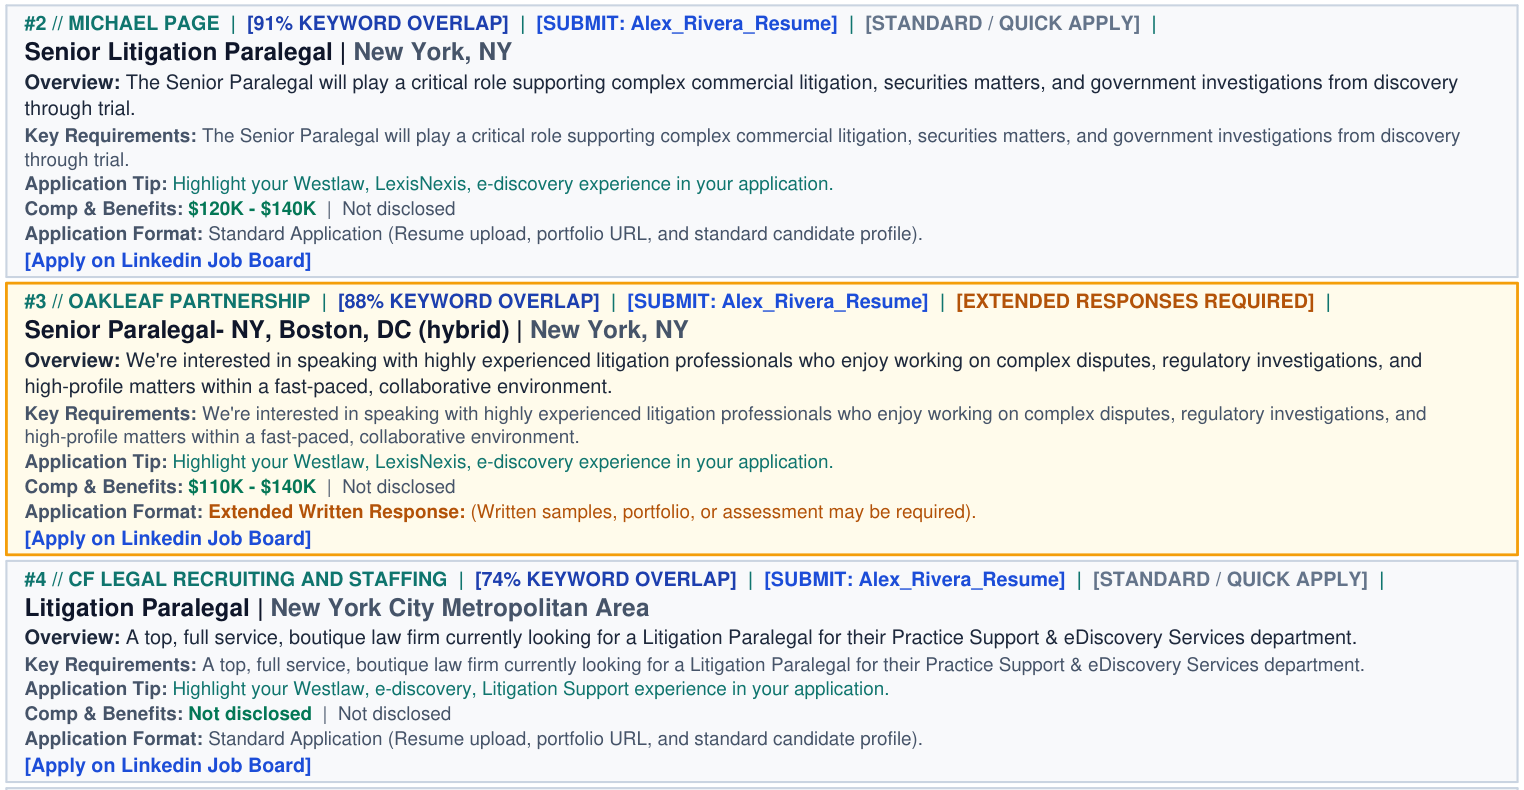
各カードは募集中の求人 1 件を表します。次の例は、Alex のパラリーガル向けスイープのカードです。
┌────────────────────────────────────────────────────────────────────────┐
│  Rank: #1                                                              │
│  Match: 92% KEYWORD OVERLAP                                            │
│  [SUBMIT: Alex_Rivera_Resume]                                          │
│  [STANDARD / QUICK APPLY]                                              │
│                                                                        │
│  Role: Litigation Paralegal                                            │
│  Company: Hoagland Longo Moran Dunst Doukas                            │
│  Location: New Brunswick, NJ, US                                       │
│                                                                        │
│  Overview: About the Role: Hoagland, Longo, Moran, DunstDoukas, LLP is │
│  seeking an experienced and detail-oriented Litigation Paralegal to    │
│  support attorneys.                                                    │
│  Key Requirements: Associate's degree, bachelor's degree, or Paralegal │
│  Certificate from an ABA-approved program preferred.                   │
│  Application Tip: Highlight your e-discovery, Legal Research,          │
│  document management experience in your application.                   │
│                                                                        │
│  Comp & Benefits: $45K - $65K  |  Not disclosed                        │
│  Application Format: Standard Application                              │
│  Apply: [Apply on Indeed Job Board]                                    │
└────────────────────────────────────────────────────────────────────────┘
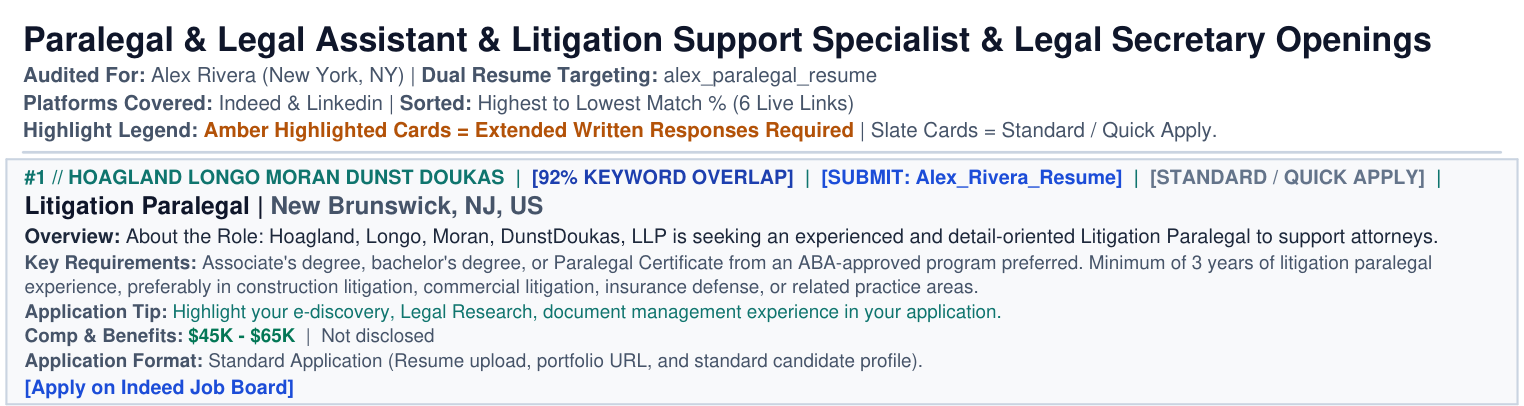
マッチ率スコア
エンジンは求人票を解析し、履歴書の PDF または Word ファイルから抽出したテキストと比較します。要件の一致がスコアの 60% を占め、キーワードの重複が残りの 40% を占めます。
- 要件の一致は、求人側の表現のうち、あなたの履歴書にすでに現れているものを測ります。
- キーワードの重複は、あなたの履歴書の語彙のうち、求人が繰り返しているものを測ります。
75% というスコアは、求人と履歴書が両方の指標で同じ重み付き用語の大半を共有していることを意味します。必須と明記された求人の用語は、表示のない用語の 2 倍の重みを持ち、歓迎と明記された用語は半分の重みを持ちます。
カードはスコアの横に 75% KEYWORD OVERLAP と表示します。この表示は合成スコアを表し、40% の内訳ではありません。Model Context Protocol(MCP)で接続したモデルは独自の割合を設定でき、そのカードは代わりに 75% MATCH と表示します。採点ガイドで計算式の全体を説明しています。
スコアは順位を示す信号として読んでください。高い数値は語彙の共有を示します。カードの Application Tip の行を確認し、年次、職務範囲、キャリアの方向性は自分で判断します。keywords_weight はプロファイルによって尺度を変えるため、スコアは同じレポート内で比較してください。
応募バッジ
[SUBMIT: <resume track>] バッジは、Sweepy がその求人を振り分けた履歴書トラックを示します。プロファイルで resume.tracks を定義すると、エンジンは各求人を最も多くの用語を共有するトラックに送ります。バッジはそのトラックの色で表示されます。履歴書が 1 つのプロファイルでは、履歴書のファイル名がトラック名になります。
給与と福利厚生
Sweepy が給与データを見つけると、給与は整形されたレンジで表示されます。Greenhouse のメタデータ、Lever の給与レンジ、Ashby の報酬区分が構造化された項目を提供します。ニューヨーク市の求人サイトである Built In NYC は各求人に給与を掲載しており、Sweepy はそれを読み取ります。Workable は給与データを送らないため、Sweepy は求人本文から最初の信頼できる数値を取り出します。
カードは求人が使った単位を保ちます。時給の職種は $45 - $55 / hour、月給の職種は $8K - $10K / month、年収の職種は $85K - $110K と表示されます。Sweepy はボーナス、株式報酬、資金調達ラウンド、手当に関わる数値は除外します。構造化された項目だけを読み取るには、プロファイルで search.salary_from_description: false を設定します。
search.min_salary のフィルターは年収で比較します。Sweepy は時給を 2,080 時間で、月給を 12 か月で換算します。その後、年収の上限が search.min_salary を下回る求人を除外します。
モデルを使わない場合、福利厚生は常に Not disclosed と表示されます。MCP で接続したモデルは submit_judgments を通じて両方の行を書き込み、サイトが公開していなかった給与データも指定できます。
応募のヒントとプレイブック
カードのヒントと末尾の戦略表は、それぞれ別の役割を担います。各カードは独自のヒントを表示し、レポートは 1 つの戦略表で締めくくります。
Application Tip はすべてのカードに表示されます。採点処理は、求人と履歴書が共有する上位 3 つの用語を選び、1 つの文で示します。重なる用語がない場合、ヒントは一般的な指示に切り替わります。
Highlight your Litigation Support, document management, court filings experience in your application.
Tailor your cover letter to the core responsibilities listed in the role.
モデルは submit_judgments の alignment フィールドでこの行を置き換えられます。
Playbook はレポートごとに 1 回、最終ページの最後のカードの後に表示されます。見出しは APPLICATION STRATEGY // DUAL RESUME ROUTING & WORKFLOW PLAYBOOK です。表は Amber の求人と Slate の求人を分け、各履歴書トラックが受け持つ求人件数を示します。
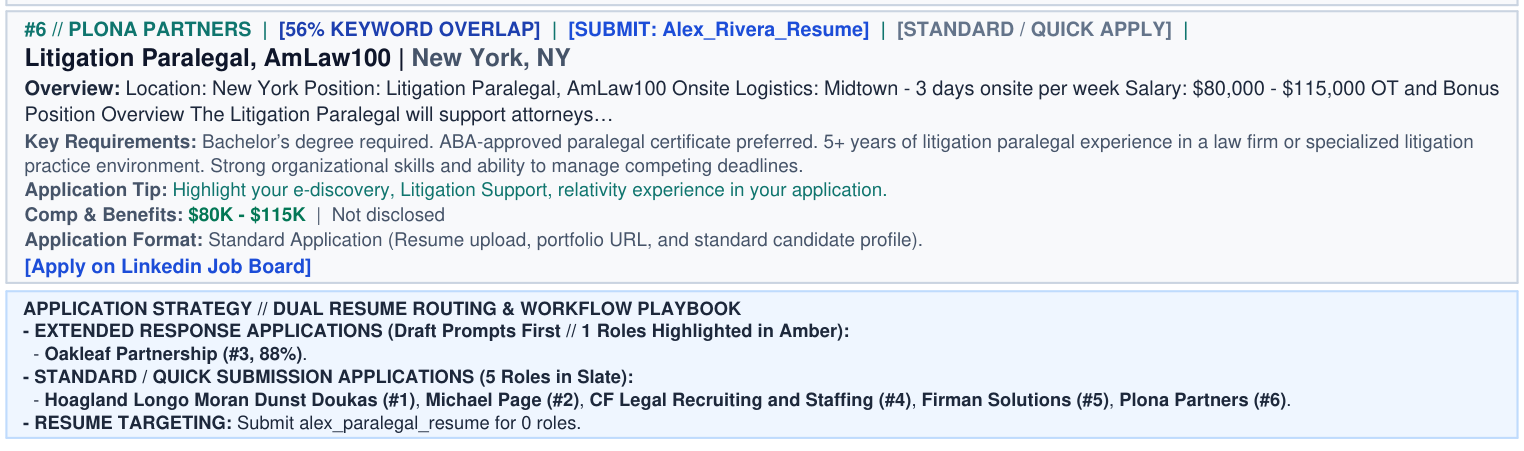
MCP 経由では、アシスタントがこの表を独自の戦略メモに置き換えられます。テキストを平文として render_report に渡すと、入力した内容に近い形で表示されます。アンパサンドと山かっこはそのまま残り、改行は行の区切りになり、**bold** は強調を加えます。Sweepy はメモをセッションと一緒に保存します。後から再生成してもメモは残ります。
クリックできるリンク
各カードは求人自体にリンクします。ネイティブの読み取りでは雇用主の採用ページを、アグリゲーターの場合は元の求人サイトを指します。[Apply on <platform> Job Board] を選ぶと、そのページがブラウザーで開きます。Sweepy は Greenhouse、Lever、Ashby、Workable、Built In NYC から求人をネイティブに読み取ります。任意の openroles エンジンと jobdrop エンジンは Workday を追加します。
応募バッジと履歴書トラック
Sweepy は各求人を走査して長文回答の兆候を探し、すべてのカードにバッジを付けます。バッジは、リンクを開く前に、その応募にどれだけの手間がかかるかを示します。
- Slate のカードは標準応募またはクイック応募を示します。応募では履歴書のアップロードと基本的な連絡先の入力だけを求めます。ほとんどは数分で終わります。
- Amber のカードは長文の記述回答を示します。応募には実際の文章作成が必要です。ポートフォリオのサンプル、カバーレター、企業についての独自の小論文課題を想定してください。
バッジを使って作業のペースを配分します。15 分の短い休憩中に Slate の応募を 5 件から 10 件提出します。Amber の応募は、独自の回答を書くための集中できる 1 時間が取れたときに回します。
CSV エクスポートを使う
PDF と並んで、エンジンは対になる CSV ファイルを書き出します。CSV は Comma Separated Values の略で、ファイルには表形式の生データが入ります。
PDF は読むこととリンクを開くことに向きます。CSV はパイプラインの管理に向きます。各行にはカードの項目と求人の抜粋が入ります。Sweepy は抜粋を 1,000 文字に整え、文の区切りで切ります。抜粋は Notion のセル上限 2,000 文字に収まり、Excel でも読みやすく表示されます。badge、match_score、min_amount、max_amount、currency、key_matches、missing_skills、playbook の各列は、PDF がバッジ、割合、給与レンジ、応募のヒントとして表示する値を繰り返します。CSV には、既定で 24 枚までに制限される PDF の上限を超えた求人も入ります。
Microsoft Excel または Google Sheets での管理
CSV の末尾には 8 つの管理用の列があります: date_applied、status、interview_stage、offer_amount、offer_date、follow_up_date、contact、notes です。応募が進むにつれて入力します。.csv ファイルをダブルクリックすると Excel で開けます。Google Sheets にアップロードしても使えます。
Sweepy は同じプロファイルの以前のエクスポートを読み取り、入力した内容を最新のファイルに引き継ぎます。月曜日に Applied と記した求人は、金曜日にも Applied と表示されます。照合は求人のリンクで行うため、リンクが変わっても職種、企業名、勤務地で一致します。プロファイルの export.tracking: false で、または Sweep Settings から、この列を無効にできます。
Notion へのインポート
Notion は CSV の行をフルページのデータベースに追加します。既存の行は更新しないため、ファイルは 1 回だけインポートし、その後の変更は Notion 内で管理します。
CSV を Notion のデータベースにインポートするには、次の手順を実行します。
- Notion のワークスペースを開きます。
- ページを作成し、Get started with で Table または Board を選びます。
- フルページのデータベースで
...メニューを開き、Merge with CSV を選んで、生成したファイルを選択します。 - CSV の各列を Notion のプロパティに割り当てます。Notion は各見出しにプロパティを作成し、既存のプロパティと一致する見出しはそちらに入ります。
Notion は CSV からリレーション、ロールアップ、数式を作成できません。
日次のスイープ
Sweepy をインストールし、検索プロファイルを設定しました。最初のマッチレポートも読みました。
求職活動を自動化する準備が整いました。毎朝スイープを実行し、上位のマッチに応募してください。
幸運を祈ります。